Hoe je een video (audio & ondertitels) vertaalt met Claude Code of Codex
Ik gebruik AI hoofdzakelijk voor mijn vertaalprojecten. Op YouTube, TikTok of Facebook vind je veel Chinese video’s zonder automatische ondertitels of automatische vertaling.
Omdat ik ze wil begrijpen, heb ik een project gemaakt dat een groot deel van het proces automatiseert: de video transcriberen, de ondertitels vertalen en, indien nodig, zelfs automatische nasynchronisatie in het Frans.
Vanuit diezelfde basis is het ook mogelijk om automatisch clipste maken, dat wil zeggen korte fragmenten uit de video.
In dit artikel gebruik ik de vertaling Chinees → Fransals voorbeeld. Maar het principe kan op vrijwel elke taal worden toegepast. Ik raad je sterk aan om Claude Code of Codex CLI – via de opdrachtregel.
Waarom transcriptie gebruiken in plaats van OCR?
Chinese video’s hebben vaak Chinese ondertitels die direct in het beeld zijn ingebakken. Je zou dus OCR (tekstherkenning in een afbeelding) kunnen gebruiken om die ondertitels te achterhalen.
Na verschillende pogingen besefte ik echter dat deze methode nogal lang en omslachtig was. Het is uiteindelijk eenvoudiger om direct te vertrekken van de spraak in de video en die om te zetten in tekst met behulp van een automatisch transcriptiesysteem, genaamd ASR (Automatic Speech Recognition).
Het principe is dus vrij eenvoudig:
Video → Chinese transcriptie → correctie → Franse vertaling → Franse ondertitels → eventueel nasynchronisatie
De skill voorbereiden
Om dit proces te automatiseren, raad ik aan om vooraf een paar referentiebestanden in de skillklaar te zetten. Ze bevatten de regels die de agents moeten volgen. Zo kun je het gedrag van het systeem makkelijk aanpassen zonder de hele workflow te herschrijven.
references/
├── translation_rules.md   # vertaalregels
├── glossary_zh_fr.md      # eigennamen en terugkerende termen
├── formatting_rules.md    # regels voor de weergave van ondertitels
└── quality_check.md       # kwaliteitscontroles
Deze bestanden kunnen met behulp van AI worden voorbereid. Ik raad je alleen aan om AI te vragen een paar varianten of voorbeelden van vertalingen voor te stellen en vervolgens de toon en regels te kiezen die bij je passen.
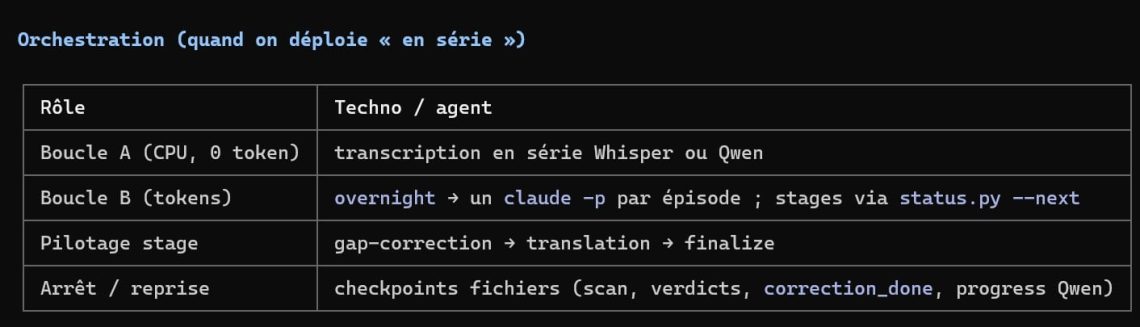
Om te voorkomen dat de hoofdsessie wordt overladen met de tekst van de hele video, kan de workflow vervolgens gebruikmaken van autonome agents. Elke agent ontvangt alleen de informatie en referentiebestanden die hij nodig heeft. Een agent kan zich bijvoorbeeld bezighouden met transcriptie, een andere met vertaling en weer een andere met kwaliteitscontrole. De hoofdsessie dient vooral om de verschillende stappen te orkestreren.
Het volledige proces
1. Chinese spraak omzetten in ondertitels
We beginnen met het ophalen van de originele video. Voor YouTube, Facebook of TikTok kun je yt-dlp.
gebruiken. Vervolgens gebruiken we een spraakherkenningssysteem (ASR) om de Chinese spraak om te zetten in tekst. Het resultaat is een ondertitelbestand .srt met de Chinese tekst en de begin- en eindtijden van elk segment.
Je kunt onder andere gebruiken:
- faster-whisper (medium)
- Qwen3-ASR ForcedAligner
Voor het Chinees gebruik ik liever Qwen3-ASR. Het kan met name context meegeven vóór de transcriptie, wat het model kan helpen het juiste teken te kiezen wanneer meerdere woorden hetzelfde worden uitgesproken.
Als u daarna van plan bent om aan nasynchronisatie of clippings te doen, schakel dan ook detijdstempeling op woordniveauin. Zo krijgt u een veel nauwkeurigere uitlijning tussen tekst en stem.
2. De passages ophalen die niet zijn getranscribeerd
Een automatische transcriptie is niet altijd perfect. De aanwezigheid van muziek kan de ASR bijvoorbeeld verstoren. Het systeem kan een passage soms als muziek of gezang beschouwen en de spraak niet correct transcriberen.
Om deze problemen op te sporen, kunt u in het SRT-bestand zoeken naar abnormaal lange gaten tussen twee ondertitels.
Voor elke ontbrekende passage:
- we halen de betreffende passage op met ffmpeg ;
- we beluisteren ze opnieuw;
- we starten een transcriptie uitsluitend op die passage.
Zo kunt u de transcriptie aanvullen zonder de hele video opnieuw te verwerken.
3. De Chinese transcriptie corrigeren
ASR kan fouten maken, met name bij homofonen : het model herkent het geluid correct, maar kiest het verkeerde teken of het verkeerde Chinese woord.
We lezen de verdachte passages dus opnieuw en corrigeren de transcriptie voordat we met vertalen beginnen.
Een slechte transcriptie leidt meestal tot een slechte vertaling. Deze stap verdient dus bijzondere aandacht.
4. Het Chinees naar het Frans vertalen
Zodra de Chinese transcriptie is gecorrigeerd, wordt ze opgedeeld in segmenten. De segmenten worden vervolgens verwerkt door een autonome agent gespecialiseerd in vertaling.
De agent raadpleegt met name de referentiebestanden van de skill om de vooraf bepaalde regels te respecteren:
- taalniveau en register;
- natuurlijk Frans in plaats van een woord-voor-woordvertaling;
- vertaling van eigennamen;
- terugkerende termen uit de glossarium;
- specifieke regels voor dialogen.
De vertalingen worden vervolgens samengevoegd met behoud van de tijdstempels van het Chinese bestand. Voor lange video’s is het beter om één segment per keer. Autonome agenten kunnen de tekst zo verwerken zonder de context van de hoofdsessie te verzadigen.
5. De vertaling controleren en opschonen
Zodra de vertaling klaar is, voert men verschillende automatische controles uit:
- er mag geen enkel Chinees teken in het Franse bestand achterblijven;
- het SRT-formaat moet geldig zijn;
- de tijdcodes moeten consistent zijn;
- het register moet homogeen blijven;
- de vertaling moet van begin tot eind coherent blijven.
Een andere agent kan vervolgens een kritische herlezing Chinees ↔ Fransuitvoeren. Zijn rol is om verkeerde interpretaties, weglatingen en vertalingen die de oorspronkelijke betekenis veranderen op te sporen. Deze controle is bijzonder nuttig wanneer de vertaling segment per segment is uitgevoerd: ze maakt het mogelijk om na te gaan dat het geheel coherent blijft.
Ten slotte bereidt men de ondertitels voor op weergave op het scherm:
- men splitst de tekst op natuurlijke plaatsen;
- men verdeelt de tekst over één of twee regels;
- men controleert de lengte en de leesbaarheid;
- men zorgt ervoor dat er geen enkel woord verloren is gegaan.
Het originele Chinese bestand wordt als referentie bewaard om de twee versies te kunnen vergelijken.
6. Het eindresultaat
Het belangrijkste resultaat is een bestand:
video.fr.srt
Het bevat de Franse ondertitels met hun tijdcodes.
Op basis van dit bestand kan men vervolgens:
- de Franse ondertitels in de video branden met ffmpeg;
- een ingesproken Franse versie genereren (text-to-speech, met de gratis stemmen van Edge of Mac);
- automatisch clippings maken of videofragmenten op basis van de ondertitels en hun timestamps.
Samengevat
De volledige workflow kan als volgt worden samengevat:
Chinese video → transcriptie → correctie → vertaling → kwaliteitscontrole → Franse ondertitels → nasynchronisatie / clippings
Het nut van deze organisatie is dat de verschillende taken duidelijk worden gescheiden en dat de autonome agenten de meest omvangrijke delen verwerken. De hoofdsessie blijft zo licht en richt zich op de orchestratie van de workflow.